13PainHunt 最近更新 · 28 天前 返回作品目录 返回
作品概览 · pain-hunt

Pain Hunt

从公开噪音里筛值得做的痛点

内测闭源自用AI 原生SaaS开发者

PainHunt 读论坛、应用商店差评这类公开吐槽,过规则过滤和模型抽取,聚成痛点簇,再打分排成短名单——回答「该不该做一个独立产品」,不是再给你一条信息流。

自用版先盯电商卖家工具、只采英文源;验收标准是每周能不能挖出几个「确实没想到又值得深挖」的点。

界面
4 帧
代码
5,997
信号
79
提交
0
TypeScriptJavaScriptCSSDrizzleNext.jsReactTailwind CSS
图版 13 · 标本 托盘上的纸片、竹筛与放大镜
界面截图 · 原文 · 4

界面

01 1 / 4

处理漏斗

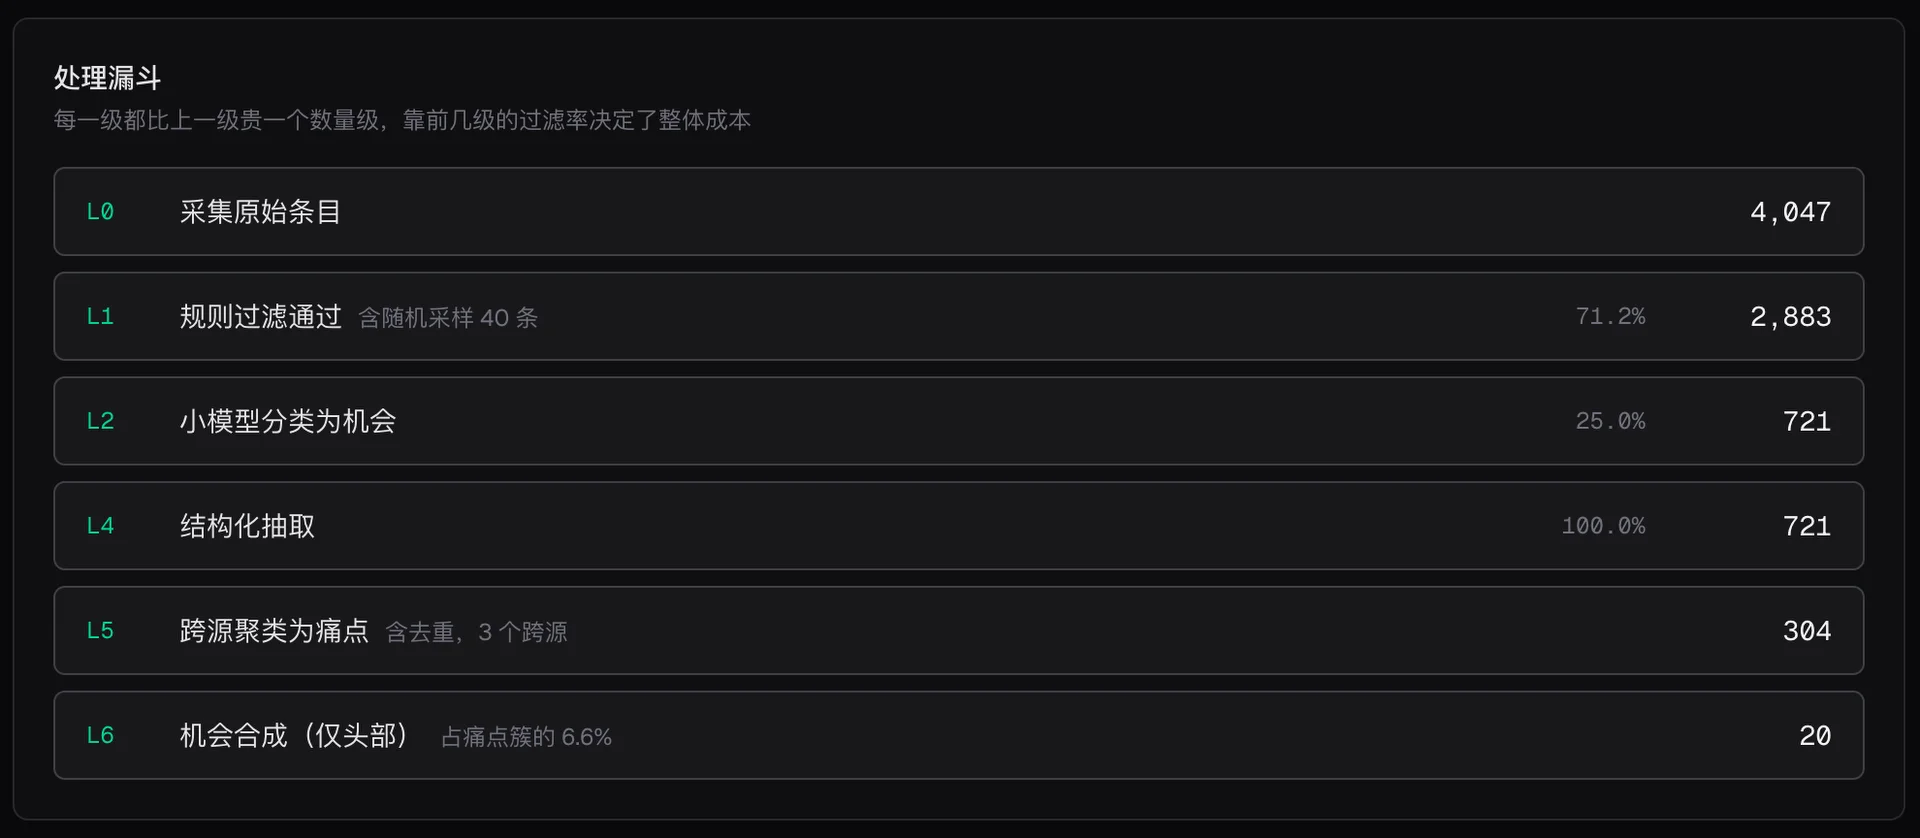
六级漏斗把 4047 条原始吐槽压到 20 个机会:L1 规则过滤(71% 通过)→ L2 小模型二分类(25% 标为机会)→ L4 结构化抽取 → L5 跨源聚类成 304 个痛点簇 → L6 仅头部 6.6% 合成机会。

副标题点明成本控制逻辑——越往后越贵,前几级过滤率决定整体 LLM 账单。深色控制台用逐级缩水的数字条,一眼看清每档留存。
PainHunt · 处理漏斗
02 2 / 4

规则诊断

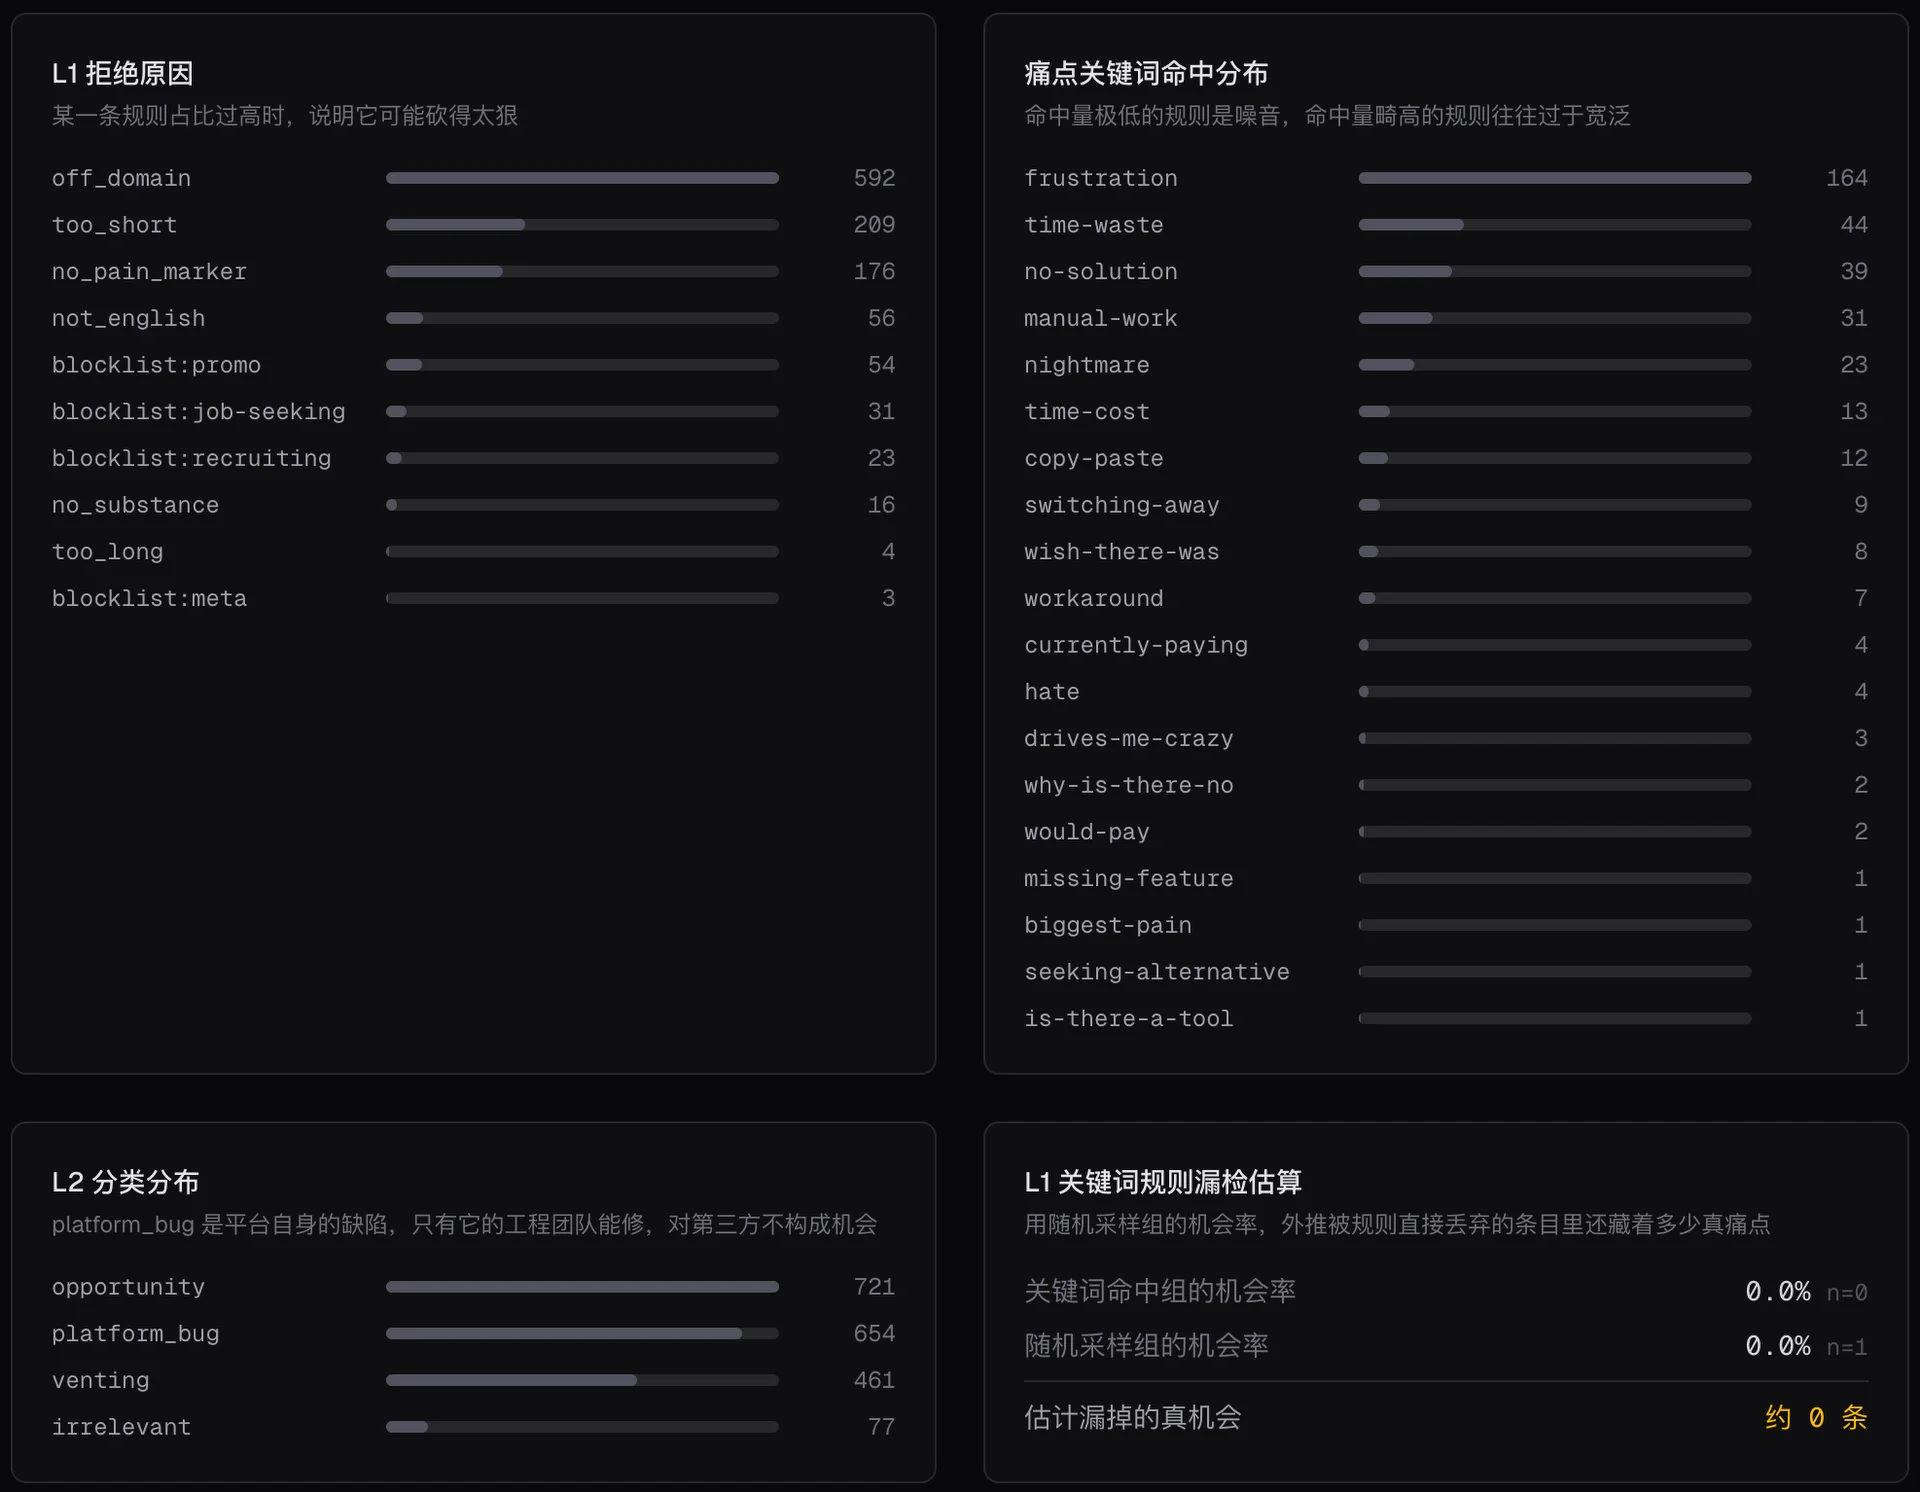
四宫格诊断 L1/L2 是否砍太狠:拒绝原因(off_domain、too_short、no_pain_marker 等)、痛点关键词命中分布、L2 分类(opportunity / platform_bug / venting / irrelevant)与随机采样漏检估算。

用来调规则阈值——某条规则占比畸高说明过滤过猛,关键词命中极低则是噪音规则。platform_bug 单独标出:平台自身缺陷不构成第三方机会。

PainHunt · 规则诊断
03 3 / 4

痛点簇

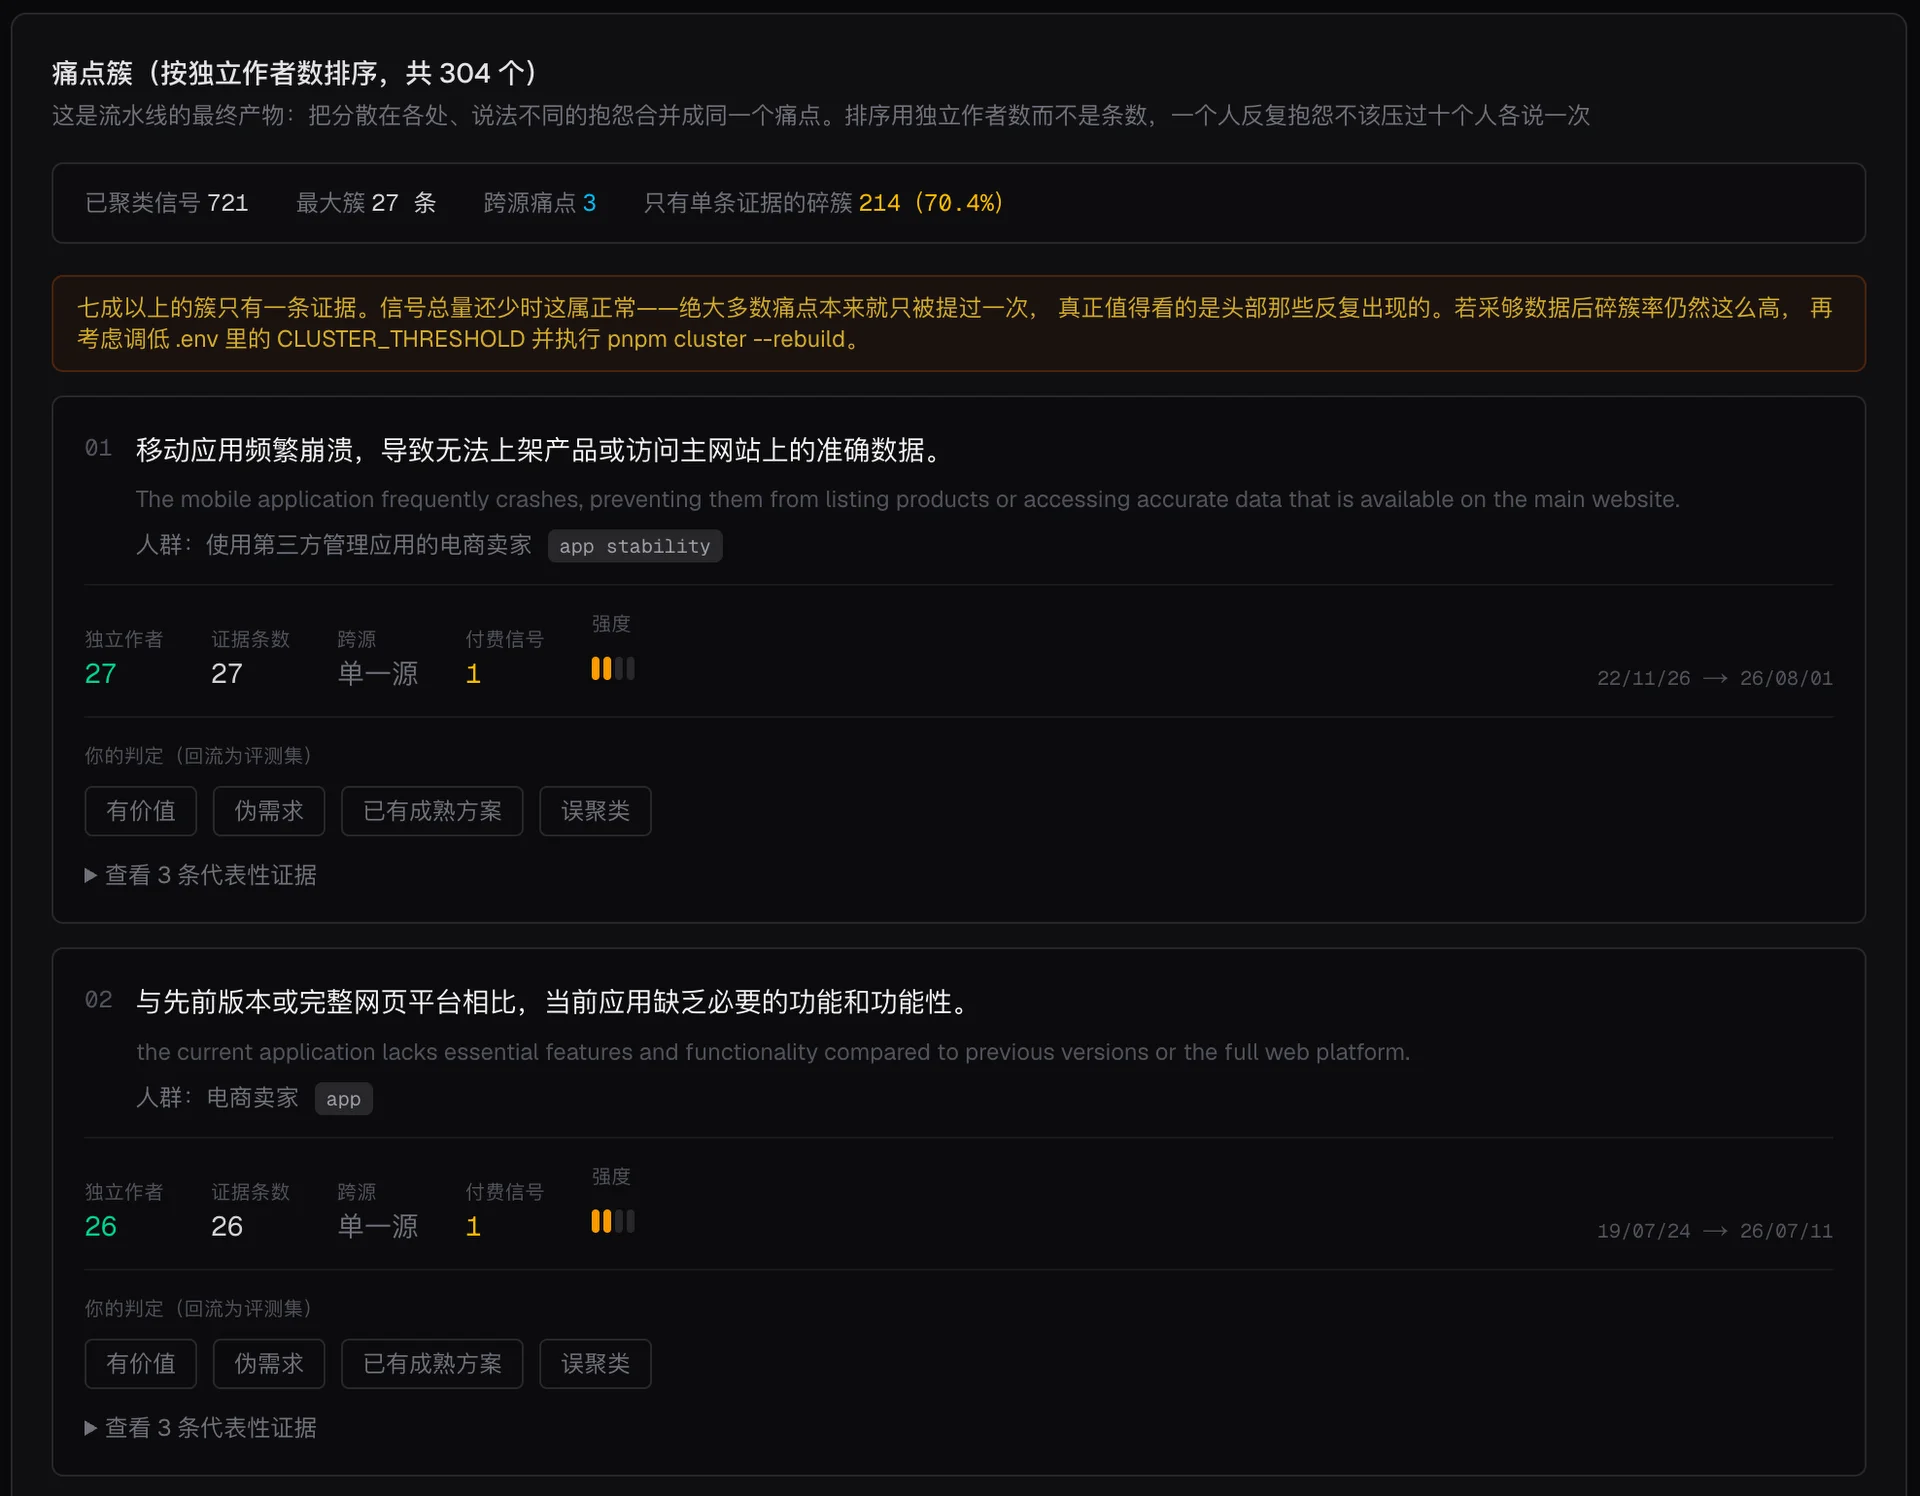
304 个痛点簇按独立作者数排序,不是按抱怨条数——避免一人刷帖撑高排名。每条展示中英摘要、人群标签、证据数、跨源情况、付费信号与强度条。

顶部汇总碎簇比例(70% 仅单条证据属初期正常),底部四键人工判定(有价值 / 伪需求 / 已有成熟方案 / 误聚类)回流评测集。可展开代表性证据链接回原文。

PainHunt · 痛点簇
04 4 / 4

机会条目

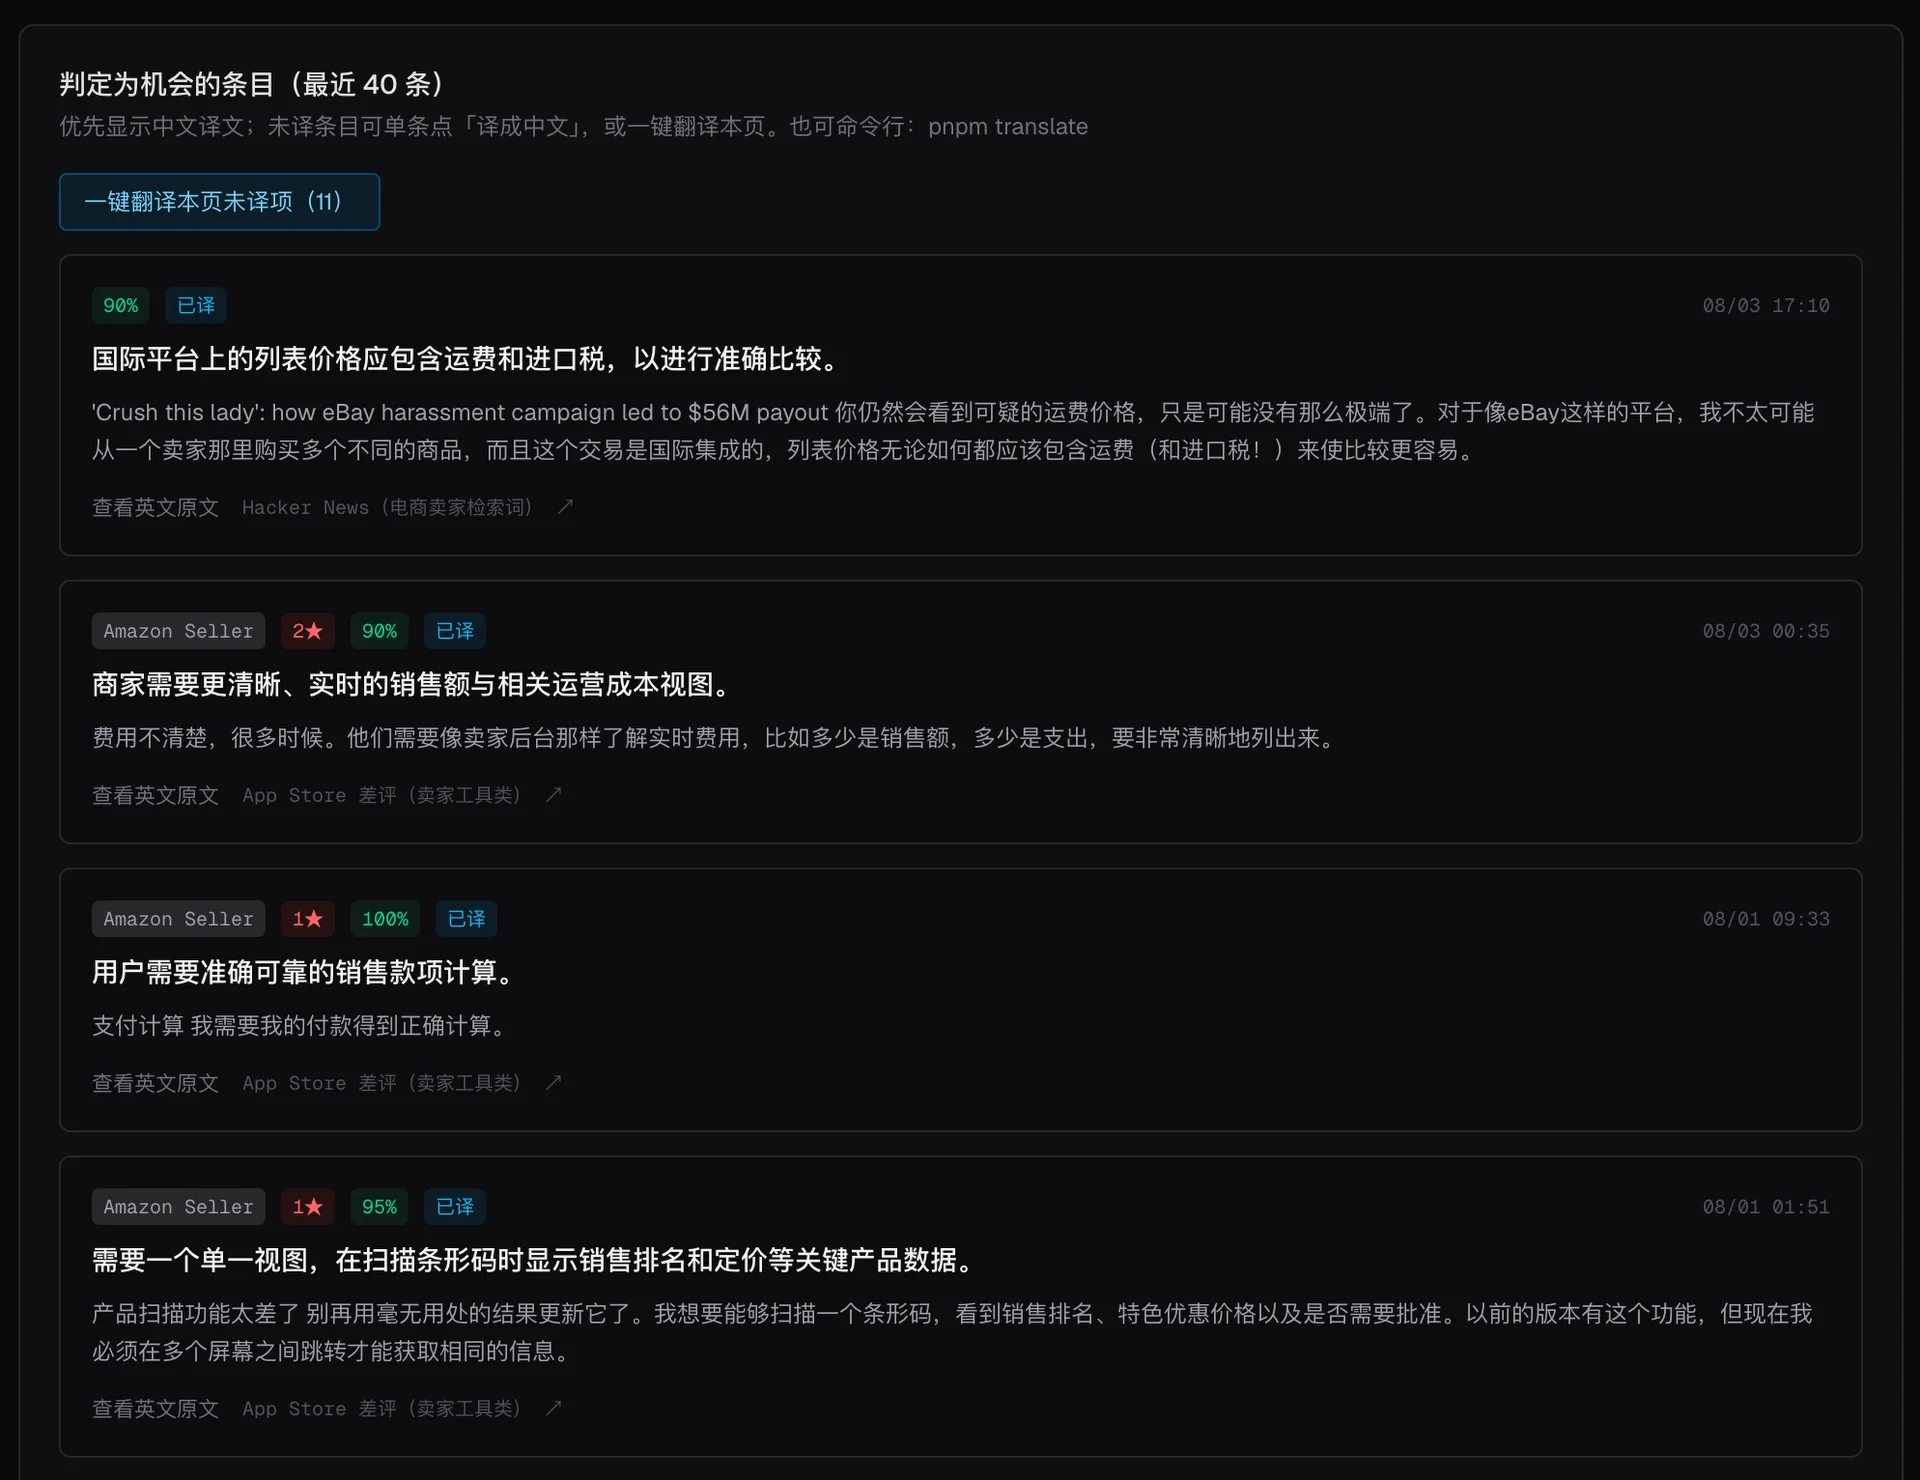
小模型判定为机会的最近 40 条:置信度徽章、来源(Hacker News 检索词 / App Store 差评)、星级与「已译」标记。中文标题优先展示,正文保留英文原文可展开。

「一键翻译本页未译项」走 `pnpm translate` 批量补中文,方便自用审阅。每条链回英文原文,强调只存引用片段与链接的合规采集策略。

PainHunt · 机会条目
架构与设计 · 原文 · 2

怎么造的

从源码读出的分层与设计决策。

PainHunt · L0–L6 成本漏斗
系统架构

L0–L6 成本漏斗

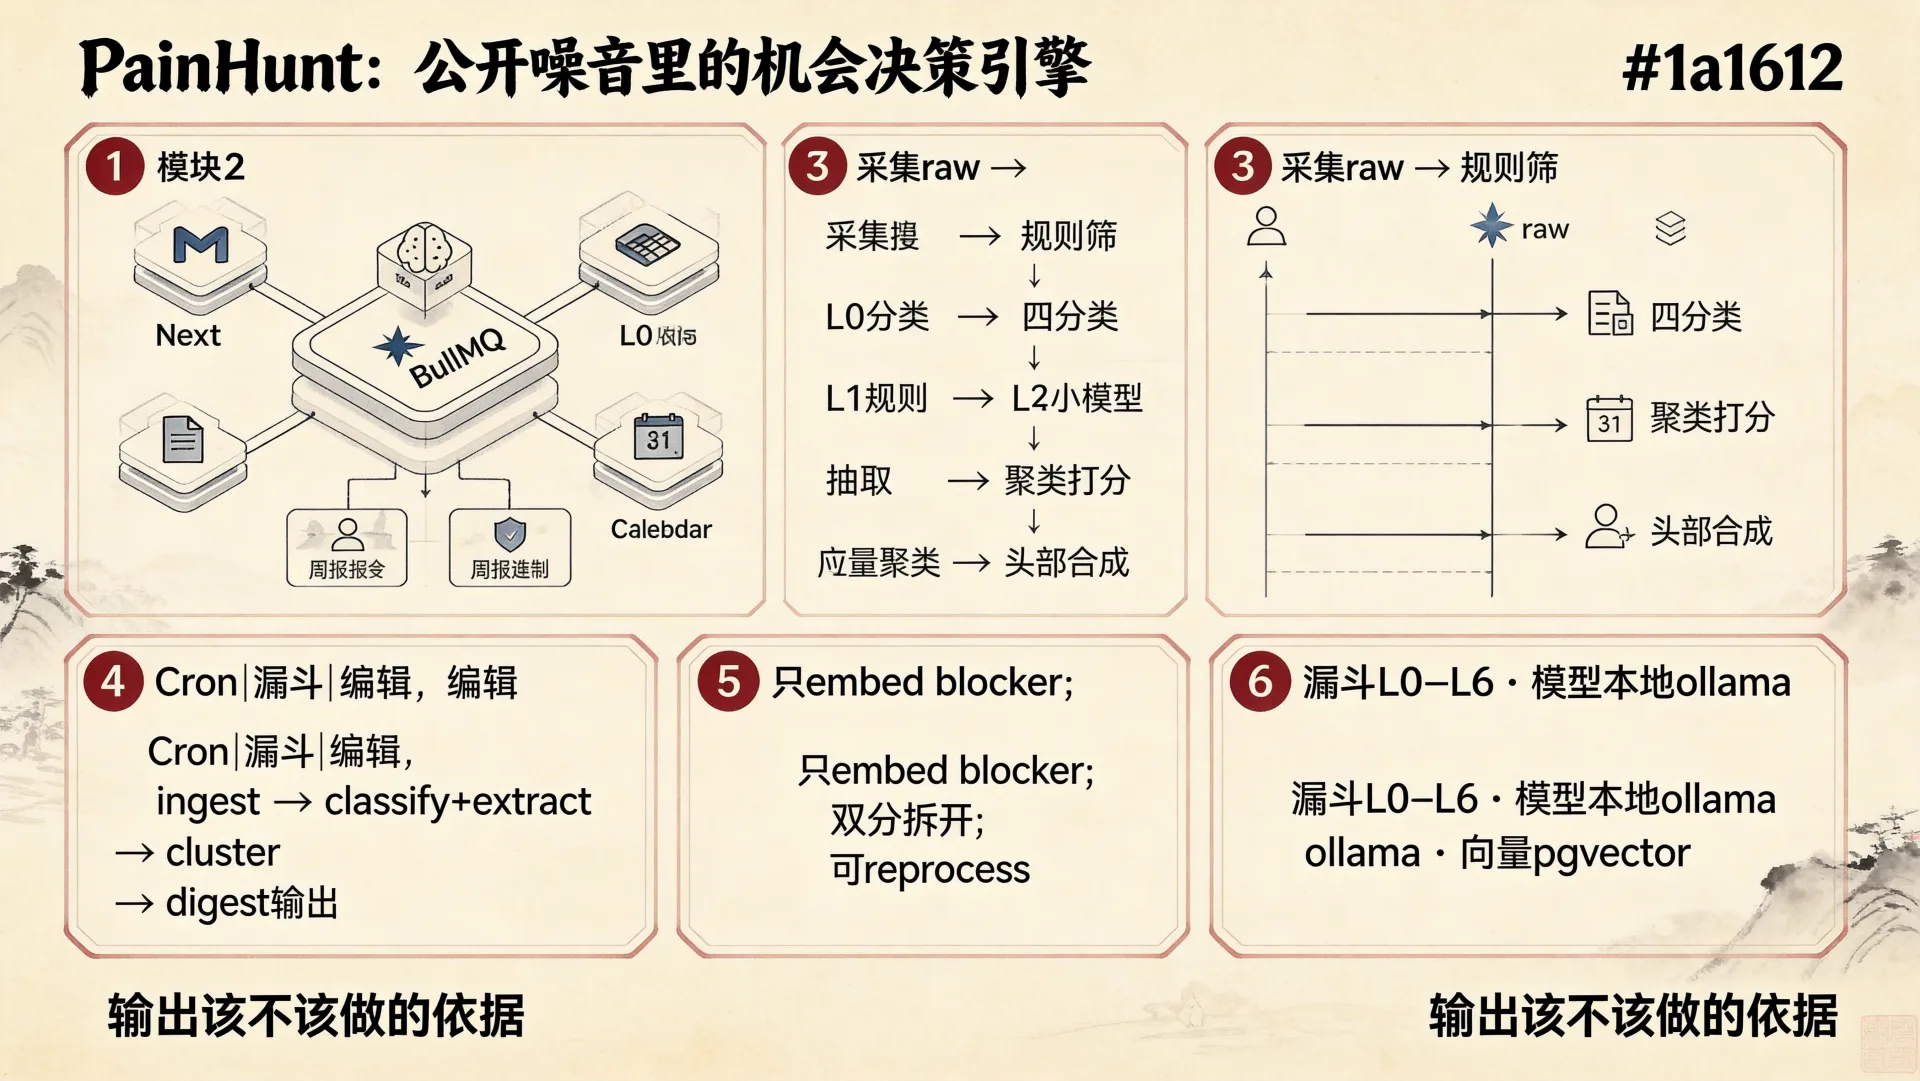
公开源入 raw(不可变)后逐级变贵变稀:规则筛 → 本地小模型四分类 → blocker 抽取与向量聚类 → 仅头部做机会合成,输出周报短名单。

跳过前级直接喂大模型会让账单涨一到两个数量级——漏斗是成本前提。
PainHunt · 双分与 blocker 对齐
亮点设计

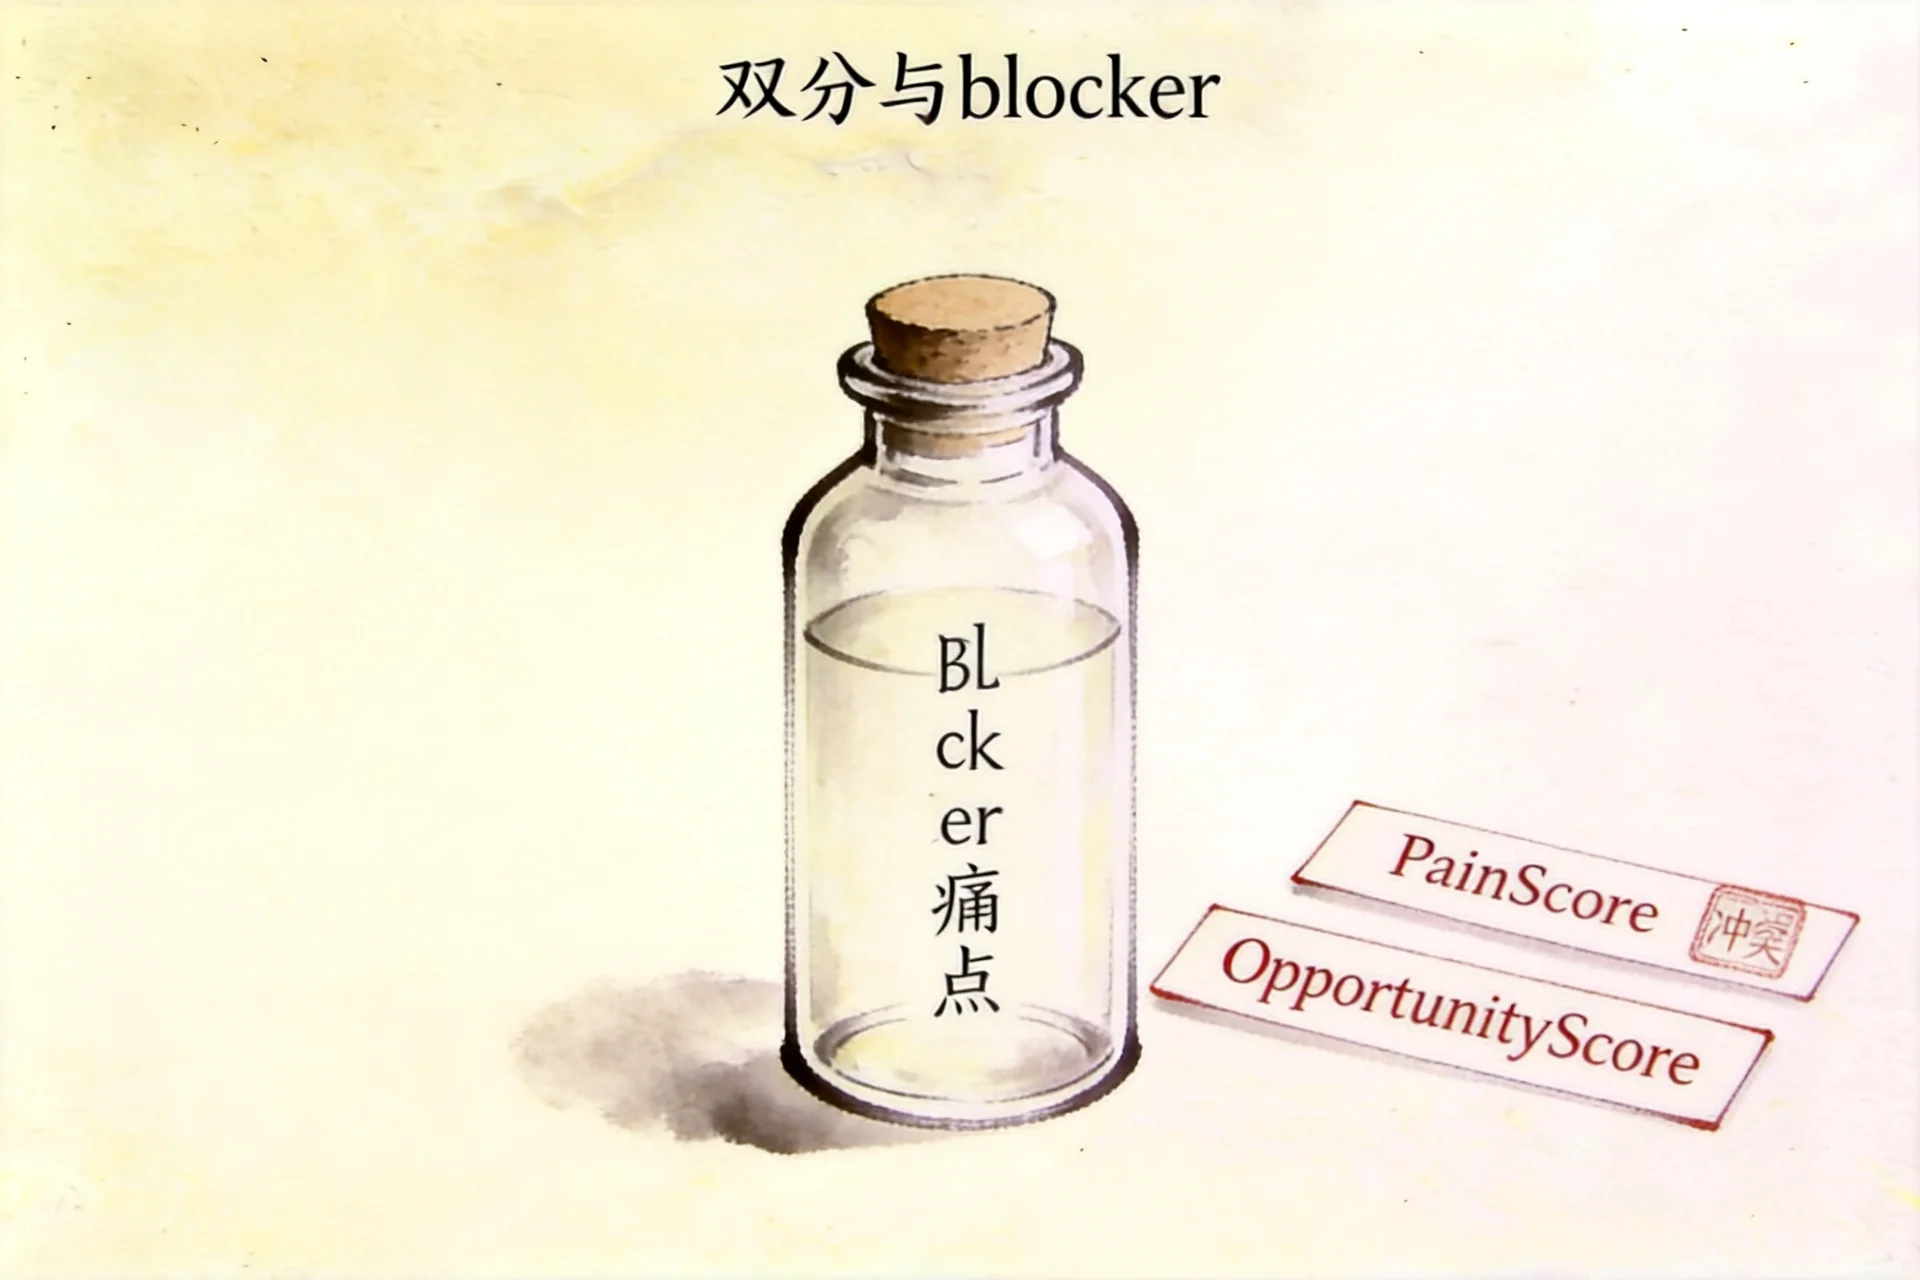
双分与 blocker 对齐

只对一句 blocker 做向量,跨源才对齐得住。PainScore 与 OpportunityScore 刻意拆开:分得清「做不了的好机会」和「没人要的点子」。

更新备忘

附录 · 12 条中的最近 6 条
2026 年 8 月 6 条

切到云端 Seed 1.6

本地 27B 太慢且 ollama 中途挂掉;解析失败率也曾飙到 85%。改为火山方舟 OpenAI 兼容网关。;新增 LLM_PROVIDER=openai 路由:generateJson 可走 Ark Chat Completions;模型:doubao-seed-1-6-251015(关 thinking);L2 并发 12、L4 并发 8;嵌入仍用本地 nomic-embed-text(维度绑表结构);清掉 428 条本地时代的 l2 fetch failed,重新入队;冒烟:30 条 / 5s / 解析失败 0 / 约 0.16s/条;

27B 流水线

垂直领域切换:创作者工具

反馈与周报

评分与机会合成

聚类

其他作品